


La mayor parte de lo que una empresa paga a un modelo de lenguaje para hacer no es escribir. Enrutar un ticket de soporte a la cola correcta. Decidir si un lead cualifica. Priorizar un backlog. Puntuar el sentimiento de una respuesta. Cada una de estas tareas es un juicio con un conjunto reducido de respuestas válidas, y cada una se encarga habitualmente a un modelo que redacta un párrafo entero para entregar una sola palabra de resultado.
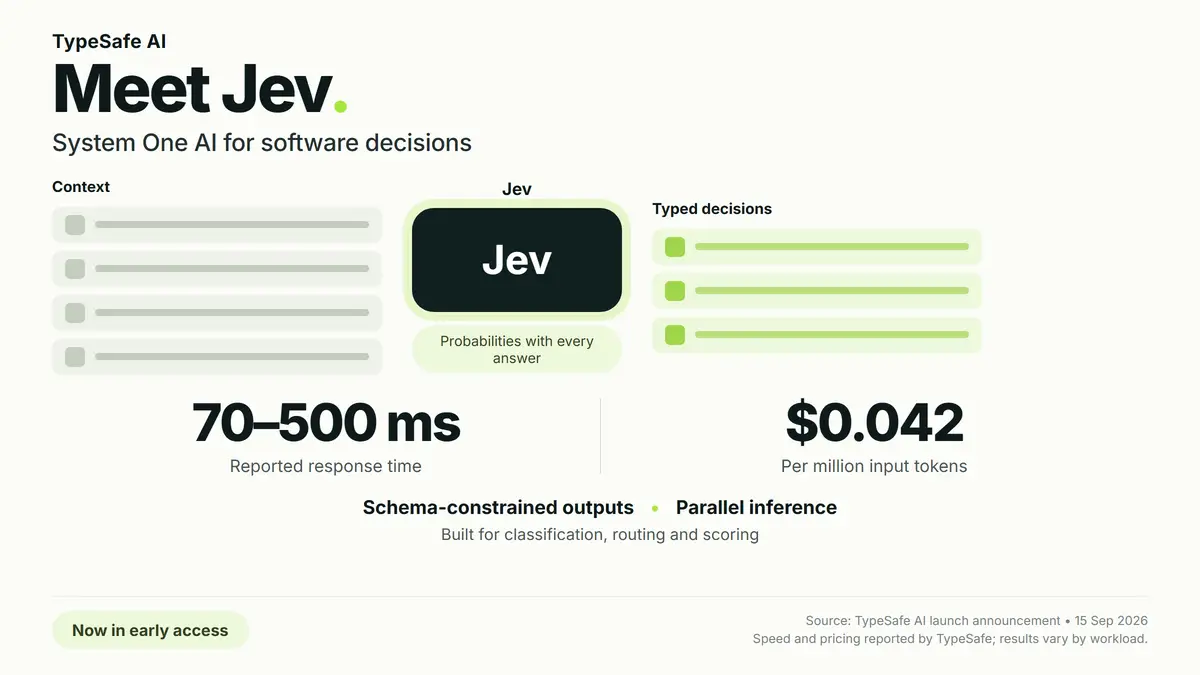
TypeSafe presentó Jev el 15 de septiembre de 2026 para hacer justo ese trabajo y nada más. Es un clasificador que vive dentro del software, no un chatbot que conversa con personas. Se le da contexto y un esquema, y devuelve una decisión tipada con una probabilidad asociada. TypeSafe reporta tiempos de respuesta de 70 a 500 milisegundos frente a 3 a 329 segundos en los modelos de frontera, con un precio de entrada de 42 dólares por mil millones de tokens y salida gratuita, porque no hay prosa que medir.
Lo que hicimos con él
La semana pasada lo probamos con nuestro propio backlog de Jira y le pedimos que decidiera qué tickets merecían prioridad. Fue rápido de configurar y barato de ejecutar. Lo barato es lo interesante: priorizar un backlog es un problema de juicio por el que llevábamos pagando precios de generación, y en el momento en que dejas de pedirle a un modelo que se explique en prosa, la factura cambia de forma.
El fundador es Diogo Almeida, que trabajó en el aprendizaje por refuerzo con retroalimentación humana que hay detrás de ChatGPT. TypeSafe cerró una ronda semilla de 40 millones de dólares liderada por DCVC. Él mismo explica el razonamiento en un vídeo breve, y con más detalle en su charla en el AI Engineer World’s Fair, I made ChatGPT, now I am building what is next.
El harness cuesta más que el modelo
Esa misma semana, un estudio de UC Berkeley y Arena puso una cifra a un desperdicio relacionado. Melissa Z. Pan, Shuo Yang y sus colegas ejecutaron modelos idénticos en tareas de programación idénticas dentro de distintos harness de agentes. El harness es el programa que envuelve al modelo: contiene el system prompt, decide qué herramientas puede ver el modelo y lleva la conversación hacia adelante.
El coste por intento varió hasta cinco veces mientras las tasas de éxito se mantenían parecidas. Claude Fable 5 costó 1,33 dólares por intento dentro de Claude Code y 0,67 dentro de Pi, un harness de línea de comandos gratuito y de código abierto de Earendil. GPT-5.6 Sol costó 0,76 dentro de Codex CLI, el harness que OpenAI distribuye con sus propios modelos, y 0,42 dentro de Pi, donde además obtuvo mejor resultado, 83,3 por ciento frente a 78,9. Un modelo no necesariamente rinde mejor dentro del harness de su propio proveedor.
| Modelo y harness | Coste por intento |
|---|---|
| Claude Fable 5 en Claude Code | $1.33 |
| Claude Fable 5 en Pi | $0.67 |
| GPT-5.6 Sol en Codex CLI | $0.76 |
| GPT-5.6 Sol en Pi | $0.42 |
Leídos junto con Jev, los dos hallazgos apuntan en la misma dirección. El modelo se está convirtiendo en el commodity. Lo que lo rodea, el harness que lleva el contexto y la decisión de si la tarea necesita prosa o no, es donde está el dinero.
Un procedimiento que puedes aplicar esta semana
No necesitas que lo comprobemos nosotros. Coge tus tres tareas de agente más frecuentes, no las más vistosas, las que se ejecutan cientos de veces por semana, porque esas son las que cargan el coste. Escribe la prueba de éxito antes de medir nada, una línea por tarea, verificable en diez segundos: “cuenta correcta encontrada” es mejor que “buena respuesta”. Fija el modelo, misma versión y misma temperatura, y cambia solo el harness, porque el harness es lo que estás midiendo.
Después compara tres cifras en lugar de una: coste por intento, tasa de aciertos y coste por intento con éxito. La tercera es la que decide. Un harness que reduce el coste a la mitad y pierde diez puntos de tasa de aciertos no te ha ahorrado nada. Repite con el ganador un segundo día antes de mover nada, porque una sola ejecución es una anécdota.
Dónde suele esconderse el dinero: el system prompt reenviado en cada llamada, descripciones de herramientas que el agente nunca invoca, la memoria de la conversación arrastrada entera en lugar de resumida, reintentos que no se contabilizan, y clasificación pagada a precio de generación. Este último punto es el hueco con forma de Jev que tienen la mayoría de los stacks.
La hoja de trabajo completa de una página, con la tabla para rellenar, está aquí para descargar, gratis y sin necesidad de registro.
Lee cualquier benchmark junto con su configuración
Una nota al pie que encaja con todo esto. ARC Prize reporta que GPT-6 Astra alcanza un 99,9 por ciento en ARC-AGI-3 con una ejecución de 19.000 dólares, una cifra que circuló mucho. Ese resultado solo se sostiene bajo una configuración Provider Adapter. El mismo modelo obtiene un 62,7 por ciento en el mismo benchmark bajo la configuración estándar. El harness movió el resultado 37 puntos, que es la misma lección del estudio de costes llegando desde el otro lado.
Este artículo lo ha escrito el equipo de Data Innovation trabajando con sus agentes de Claude. Cada cifra enlaza con la fuente primaria de la que procede, para que puedas comprobar nuestra lectura frente a ella.